
NVIDIA hat zur IFA 2026 den Personal AI Router als freie Beta veröffentlicht. Die Software verteilt unabhängige Inferenzanfragen über kompatible Rechner im selben Netzwerk. Ein KI-Agent kann dadurch mehrere lokale Systeme auslasten, ohne dass seine Anbindung an Ollama oder LM Studio geändert werden muss.
PAIR arbeitet als Proxy vor den vorhandenen Inferenzdiensten. Das Werkzeug erkennt beteiligte Rechner, prüft den laufenden Dienst, das verfügbare Modell und die aktuelle GPU-Auslastung und weist jede neue Aufgabe einem geeigneten System zu. Eine einzelne Anfrage bleibt vollständig auf einem Rechner. Der Router bündelt weder Grafikspeicher noch zerlegt er ein Modell über mehrere GPUs.
Windows, Linux und macOS können zusammenarbeiten
Die PAIR-Beta steht für Windows 11, Linux und macOS in Fassungen für x64 und Arm64 bereit. Windows auf Arm führt NVIDIA noch als experimentell. Als beschleunigte Knoten nennt der Hersteller GeForce-GPUs ab der RTX-20-Serie, RTX-PRO-Modelle ab der Turing-Generation, DGX Spark und Macs mit M4-Chip oder neuer. Ob ein konkretes Modell auf einem Knoten läuft, hängt zusätzlich vom gewählten Inferenzdienst, den Treibern und dem verfügbaren Speicher ab.
Die technische Beschreibung von PAIR nennt mDNS für die Erkennung im Netz, einen sechsstelligen Code für das Koppeln und gegenseitige TLS-Authentifizierung für die verschlüsselte Kommunikation. Prompts und Antworten bleiben nach dem vorgesehenen Aufbau im lokalen Netz. Das gilt nur, wenn auch Agent, Modellquelle, Inferenzdienst und alle beteiligten Knoten lokal arbeiten.
Der Quellcode steht unter der Apache-Lizenz 2.0. Die aktuellen Release Notes zu Version 0.1.1 nennen eine Korrektur im Build-Werkzeug für x64-Ziele. Die Anwendung selbst ist funktional identisch mit Version 0.1.0. Signierte Installationspakete gibt es als EXE, Debian-Paket und DMG.
llama.cpp erreicht laut NVIDIA bis zu 1,9-fachen Durchsatz
Neben dem Router veröffentlicht NVIDIA neue Optimierungen für llama.cpp und vLLM. Auf einer GeForce RTX 5090 soll llama.cpp je nach Modell den 1,5- bis 1,9-fachen Durchsatz erreichen. Für vLLM nennt das Unternehmen den Faktor 1,2 auf einer RTX PRO 6000 Blackwell und bis zu 1,4 auf einem Verbund aus zwei DGX-Spark-Systemen. Die Werte stammen aus Messungen des Herstellers und lassen sich nicht ohne identische Modelle, Quantisierung und Laufzeitparameter auf andere Rechner übertragen.
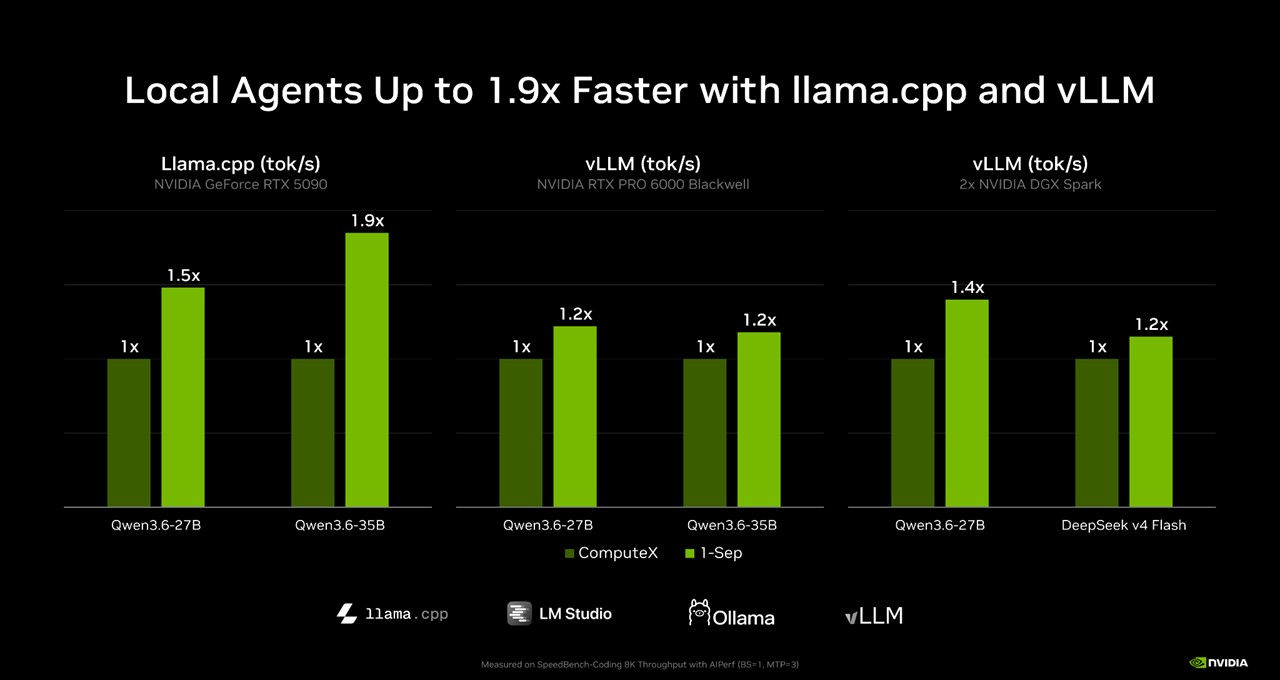
Die Änderungen stehen direkt in den beiden Inferenz-Backends sowie über LM Studio und Ollama zur Verfügung. Hermes Agent erhält unter Windows eine Ein-Klick-Einrichtung, die eine vorhandene NVIDIA-GPU erkennt und ein passendes Modell auswählt. OpenClaw soll seine Windows-App auf RTX-GPUs mit mindestens 24 GB Grafikspeicher vereinfachen. Perplexity bietet Portable Computer derzeit für Linux-Systeme mit mindestens 24 GB Grafikspeicher an, eine Windows-Fassung ist angekündigt.
RTX Spark PCs sollen im Oktober erscheinen
Parallel kündigt NVIDIA die ersten RTX Spark PCs für Oktober 2026 an. Die Plattform kombiniert laut Hersteller bis zu 128 GB gemeinsamen Speicher, eine Grace-CPU mit 20 Kernen und eine Blackwell-GPU mit bis zu einem Petaflop KI-Rechenleistung. Acer zeigte auf der IFA ein kompaktes Desktop-Konzept, Lenovo stellte Yoga Pro 9n und Yoga 9n 2-in-1 vor.
Bereits zur gamescom 2026 kündigte NVIDIA weitere Spiele und Technik für RTX Spark an. Electronic Arts, Embark und Ubisoft gehören laut der neuen IFA-Meldung zu den Studios und Publishern, die Titel auf die Plattform bringen. Preise für die im Oktober erwarteten Systeme nennt NVIDIA noch nicht.