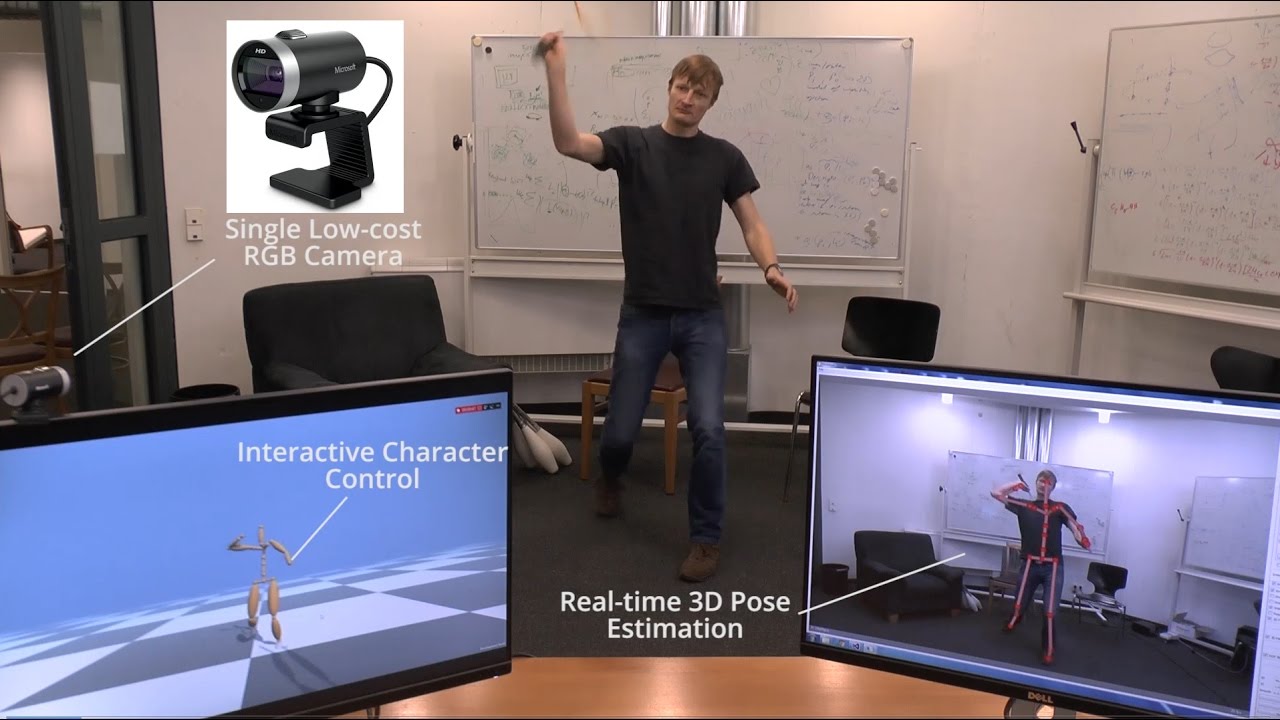

Forscher des Max-Planck-Instituts für Informatik haben mit VNect ein Verfahren zur Schätzung von 3D-Körperposen aus einer einzelnen Webkamera vorgestellt. Die Mitteilung vom 5. Juli 2017 beschreibt eine Echtzeit-Anwendung ohne Marker und ohne Tiefenkamera. Erfasst wird ein Skelettmodell einer Person, kein vollständiger Scan ihrer Körperoberfläche.
Die offizielle Projektbeschreibung verbindet ein neuronales Netz mit der Anpassung eines kinematischen Skeletts. Das Netz schätzt Gelenkpositionen in zwei und drei Dimensionen; die anschließende Anpassung soll die Pose über mehrere Bilder hinweg stabilisieren. Das Forschungsvideo von VNect zeigt die Übertragung auf eine digitale Figur.
Bewegungssteuerung ohne Tiefensensor
Die Autoren nennen die Steuerung von Spielfiguren und virtuelle Realität als mögliche Anwendungen. Das Verfahren lässt sich nach ihren Angaben auch auf Außenaufnahmen und bereits aufgezeichnetes Videomaterial anwenden. Die auf arXiv seit dem 3. Mai 2017 veröffentlichte Arbeit beschreibt den Forschungsansatz, nicht die Integration in ein bestimmtes kommerzielles Spiel.
Bei Kinect v2 können Tiefen- und Farbdaten als Punktwolke in ROS übertragen werden. VNect geht anders vor: Die räumliche Körperpose wird aus dem RGB-Bild geschätzt. Ein solcher Ansatz ersetzt nicht sämtliche Messdaten eines Tiefensensors.
Verdeckungen und mehrere Personen begrenzen die Erkennung
Die Campus-Mitteilung nennt geringere Genauigkeit als bei Systemen mit mehreren Kameras oder Markern. Verdeckte Gesichter, sehr schnelle oder vom Trainingsmaterial abweichende Bewegungen und mehrere Personen vor der Kamera bereiteten dem damaligen System Probleme. Das ist für den Einsatz als Eingabeverfahren wichtiger als die bloße Zahl der benötigten Kameras.
Archivhinweis: Der Beitrag dokumentiert den Forschungsstand vom Juli 2017. Spätere Bibliotheks-Updates der Projektseite werden nicht als damals verfügbare Software dargestellt.