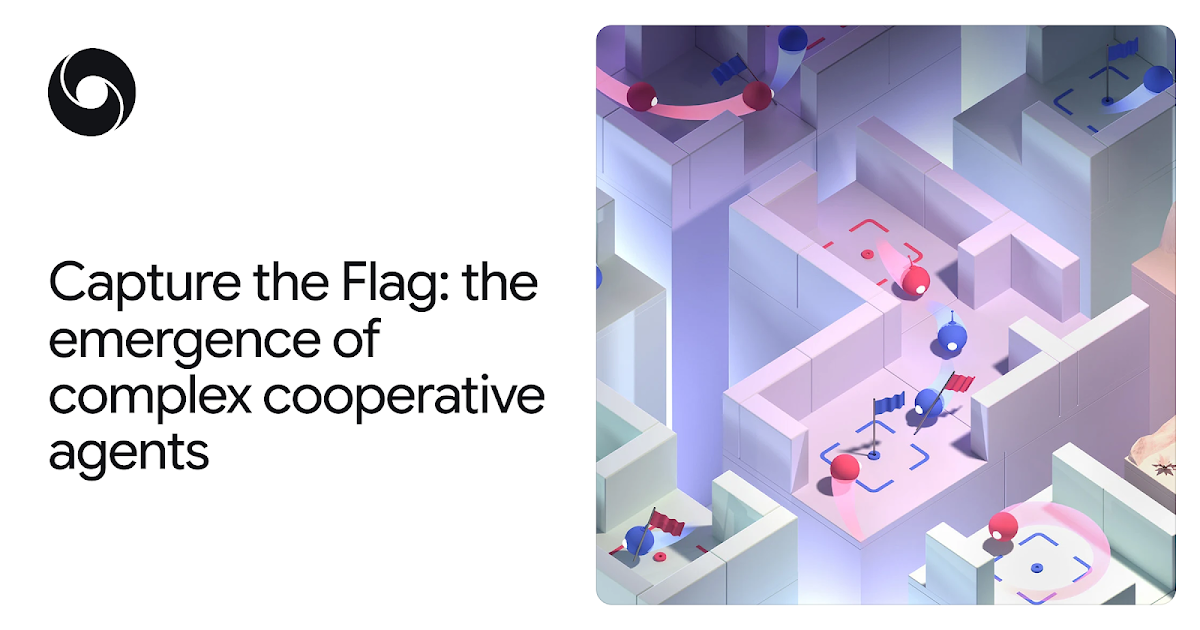

DeepMind hat einen Agenten vorgestellt, der im Capture-the-Flag-Modus von Quake III Arena eigenständig Teamplay lernt. Der For-the-Win-Agent trainiert in einer angepassten Version des Multiplayer-Shooters und erreicht dabei laut DeepMind ein menschliches Leistungsniveau.
Die Besonderheit liegt nicht nur in der Zielgenauigkeit. Der Agent muss die Flagge des gegnerischen Teams erobern, die eigene Basis schützen und seine Aktionen mit Teammitgliedern koordinieren. DeepMind trainierte eine Population von Agenten, die gegeneinander und miteinander spielte, statt nur eine einzelne festgelegte Strategie zu optimieren.
Reinforcement Learning aus Bilddaten und Spielpunkten
Als Eingaben dienen die Beobachtungen aus dem Spiel und die Punkte aus der laufenden Partie. Rekurrente neuronale Netze verarbeiten Informationen über schnelle und langsamere Handlungsmuster. Das Training erzeugt daraus interne Ziele, etwa den Angriff auf die gegnerische Flagge oder die Unterstützung eines Teammitglieds.
Die Forschungsarbeit zu population-based deep reinforcement learning beschreibt die Methode als Ansatz für komplexe Mehrspielerumgebungen. In Tests arbeitete der Agent auch mit menschlichen Teammitgliedern zusammen. Für die Spieleentwicklung ist daran vor allem interessant, dass ein System aus visuellen Beobachtungen und Spielregeln koordinierte Verhaltensweisen ableiten kann, ohne jede Taktik einzeln vorzugeben.