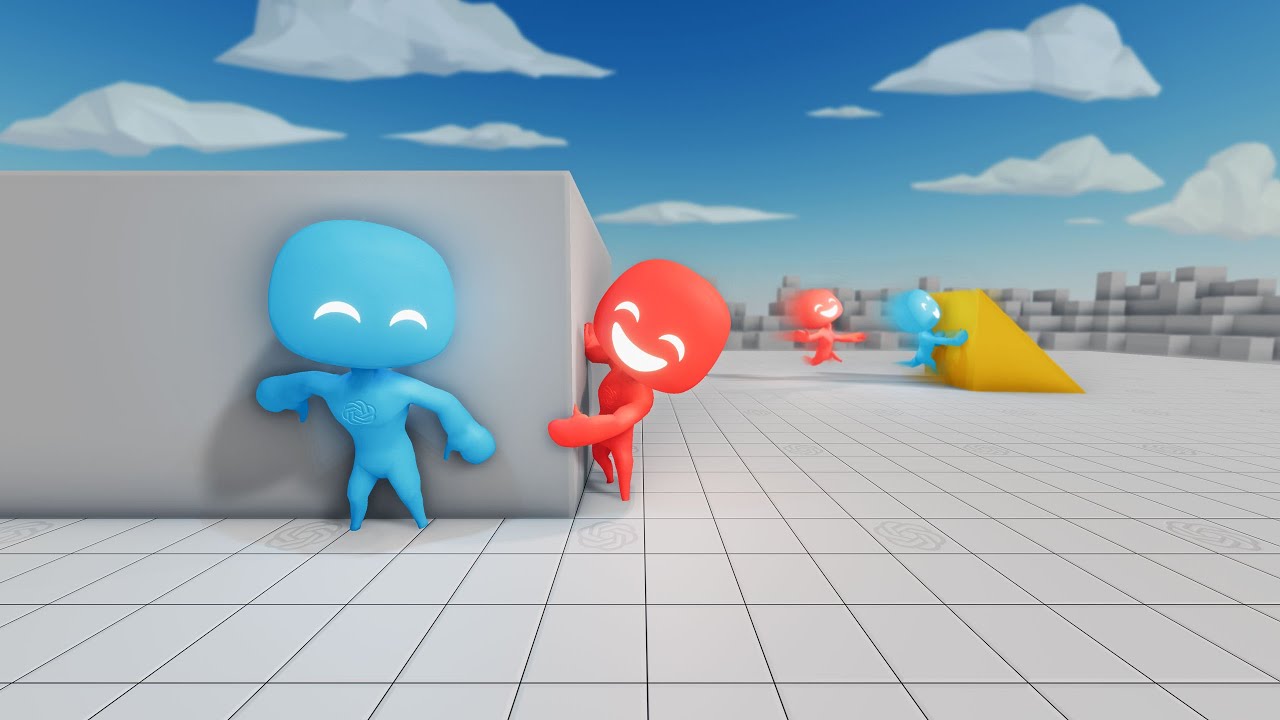

OpenAI hat am 17. September 2019 ein Versteckspiel vorgestellt, in dem KI-Agenten den Einsatz von Kisten und Rampen lernen. Zwei Teams müssen Sichtkontakt herstellen beziehungsweise vermeiden. Für Werkzeuggebrauch gibt es keine gesonderte Belohnung.
Das offizielle Video zeigt, wie Verstecke und Gegenstrategien entstehen. Die Agenten trainieren durch Selbstspiel mit Proximal Policy Optimization. Ihre Aktionen beruhen auf eigener Beobachtung und internem Gedächtnis; die Bewertungsfunktion darf beim Training zusätzliche Informationen nutzen.
Sechs Phasen und begrenzter Transfer
Die erste Fassung der Forschungsarbeit vom 17. September beschreibt sechs aufeinander aufbauende Strategiephasen. Auf den Bau von Schutzwänden folgt beispielsweise der Einsatz von Rampen, um Hindernisse zu überwinden. Der Wettbewerb erzeugt damit neue Aufgaben für das jeweils andere Team.
OpenAI berichtet auch von unbeabsichtigten Physik-Tricks. Bei anderen Testaufgaben lieferten die vortrainierten Agenten zwar oft bessere Ergebnisse, aber keine drastische Beschleunigung des Lernens. Der Versuch belegt daher keine beliebig übertragbare Problemlösefähigkeit.
Umgebungscode für eigene Versuche
Der damalige Code-Stand der Simulationsumgebungen baut auf mujoco-worldgen auf. Module ergänzen Objekte wie Kisten, Rampen und Wände; Wrapper steuern unter anderem Belohnungen und Spielmechaniken. Die Dokumentation nennt zusätzlich Aufgaben zum Festsetzen von Kisten sowie zum Bau nach Vorlage und von Schutzräumen.
Selbstspiel hatte OpenAI bereits beim Training von OpenAI Five für Dota 2 eingesetzt. Das Versteckspiel reduziert die Regeln auf eine überschaubare Forschungsumgebung.