
Unity beschreibt am 26. Juni 2018 im offiziellen Entwicklungsbericht eine neue Funktion von ML-Agents 0.4. Eine intrinsische Belohnung auf Basis von Überraschungen soll Agenten dabei helfen, Umgebungen mit seltenen Erfolgen gezielter zu erkunden. Das Toolkit trainiert damit Spiel- und Simulationsagenten nicht nur über vorgegebene Belohnungen.
Die Release-Dokumentation zu ML-Agents 0.4 führt die Version als damaligen Entwicklungsstand des Toolkits. Für die technische Umsetzung kombiniert Unity ein Vorwärts- und ein Rückwärtsmodell. Das Rückwärtsmodell leitet aus aktueller und nächster Beobachtung die ausgeführte Aktion ab. Das Vorwärtsmodell sagt aus der codierten aktuellen Beobachtung und der Aktion die nächste Beobachtung voraus. Die Abweichung zwischen Vorhersage und tatsächlichem Ergebnis dient als intrinsische Belohnung.
Pyramids testet Lernen mit seltenen Erfolgen
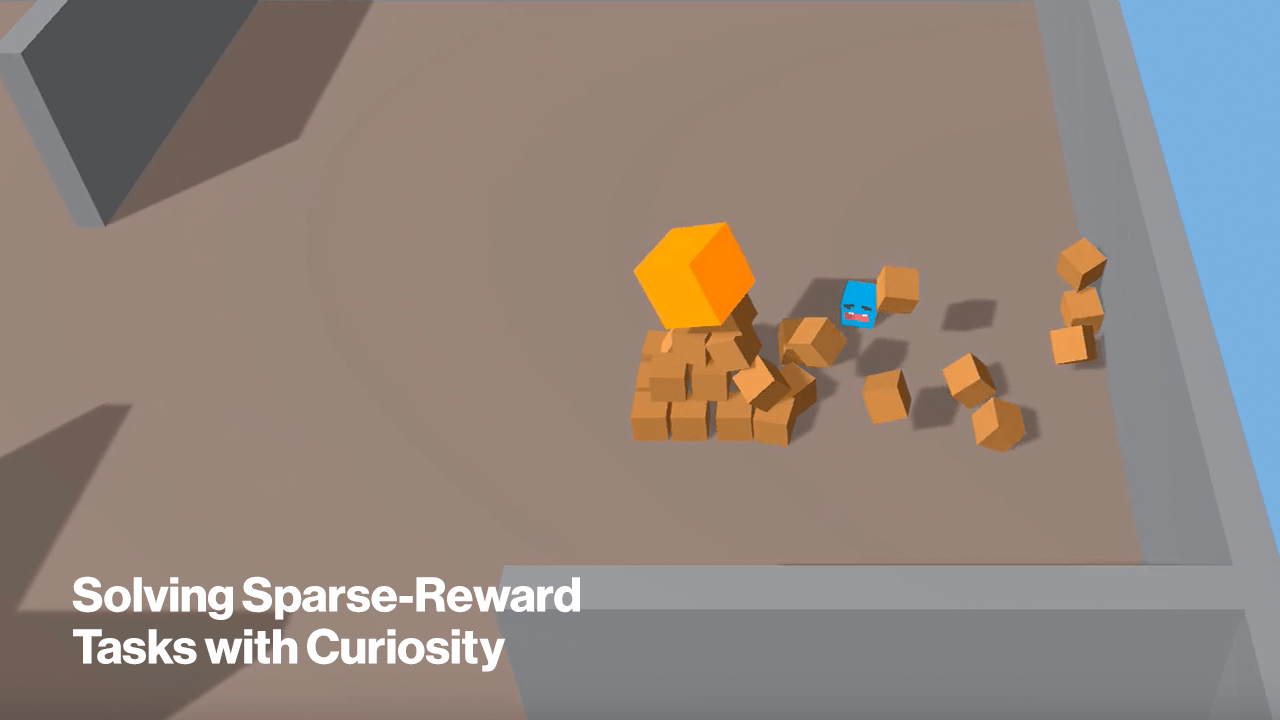
Unity prüfte die Methode in der neuen Umgebung Pyramids. Ein Agent bewegt sich durch neun Räume, aktiviert zunächst einen Schalter und muss anschließend einen zufällig erzeugten Sandsteinturm mit einem goldenen Block erreichen. Für die einzelnen Zwischenschritte gibt es keine Belohnung. Erst die Berührung des goldenen Blocks bringt zwei Punkte, wodurch zufällige Erkundung nur selten zum Ziel führt.
Mit dem üblichen PPO-Training blieb der Agent laut Unity auch nach 200.000 Schritten meist nahe am Zufallsniveau. Die Kombination aus PPO und Curiosity löste die Aufgabe dagegen wiederholt innerhalb dieses Zeitraums und teils nach etwa der Hälfte der Trainingsschritte. Selbst ohne die äußere Belohnung bewegten sich die Agenten durch mehrere Räume, statt nur kleine Kreise in einem Raum zu laufen.
Curiosity lässt sich über die Trainingskonfiguration aktivieren
Für eigene Umgebungen genügte in ML-Agents 0.4 der Eintrag `use_curiosity: true` in der Hyperparameter-Datei des jeweiligen Gehirns. Das Training konnte anschließend wie gewohnt gestartet werden. Unity nannte zusätzlich Messwerte für den Fehler des Vorwärts- und Rückwärtsmodells sowie für die kumulierte intrinsische Belohnung pro Episode.
Die Methode eignet sich laut Unity vor allem für Aufgaben mit spärlichen Belohnungen. Bei Umgebungen, in denen fast jede Aktion bereits eine dichte Belohnung auslöst, ist kein vergleichbarer Vorteil zu erwarten. Die Unity-Entwicklungsarbeit an Book of the Dead zeigt einen anderen Einsatzbereich der Engine, bei dem Echtzeitgrafik und Produktionswerkzeuge im Mittelpunkt stehen.