
Zwei im Juni 2017 veröffentlichte Arbeiten untersuchen, wie Agenten schriftliche Anweisungen mit sichtbaren Objekten und Bewegung verbinden. DeepMind beschreibt Sprachlernen in einer erweiterten DeepMind-Lab-Umgebung. Die Carnegie Mellon University stellt eine Gated-Attention-Architektur für ViZDoom-Aufgaben vor.
DeepMinds Agent erhält Bilder und eine schriftliche Aufgabe. Er lernt durch Belohnungen und zusätzliche Vorhersageaufgaben, etwa für das nächste Bild. Die Forscher variieren Objekte, Eigenschaften und Raumaufteilungen. Sie berichten eine Übertragung gelernter Begriffe auf neue Kombinationen und nutzen gestufte Trainingsaufgaben für schwierigere Raumbeziehungen.
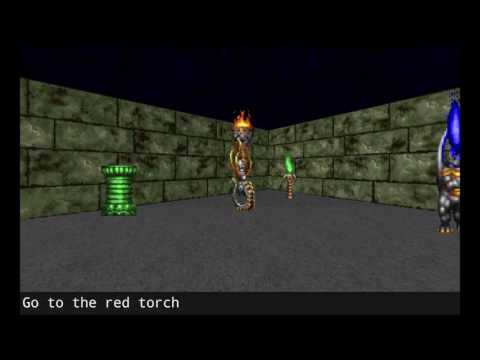
Das Paper verlinkt Felix Hills Demonstration der trainierten Agenten. Die Szenen zeigen den Forschungsaufbau, keine Funktion eines angekündigten kommerziellen Spiels.
CMU gewichtet Bildmerkmale anhand der Anweisung
Die CMU-Arbeit nutzt ViZDoom. Das Modell verarbeitet Bild und Text zunächst getrennt. Ein aus dem Text berechneter Vektor gewichtet anschließend Bildmerkmale. So soll die Anweisung bestimmen, welche Eigenschaften für die Navigation zum Ziel relevant sind.
Der Versuchsaufbau enthält 70 manuell formulierte Anweisungen: 55 für das Training und 15 für neue Merkmalskombinationen im Test. Devendra Singh Chaplots Videos zeigen bekannte Anweisungen auf neu zusammengesetzten Karten und nicht trainierte Anweisungskombinationen.
Testbedingungen sind kein allgemeines Sprachverständnis
Die Arbeiten verbinden Wahrnehmung, Navigation und Sprachverarbeitung in kontrollierten Aufgaben. Für Gameentwicklung und KI-Forschung bieten solche Szenarien einen prüfbaren Aufbau. Die Auswahl begrenzter Objekte und Anweisungen erlaubt jedoch keine Aussage über freie Dialoge oder die Zuverlässigkeit in beliebigen Spielen.
Dieser Beitrag dokumentiert DeepMinds Fassung vom 26. Juni und die CMU-Erstfassung vom 22. Juni 2017. Die Experimente werden als Forschungsergebnisse der jeweiligen Teams beschrieben, nicht als eigene Tests der Redaktion.