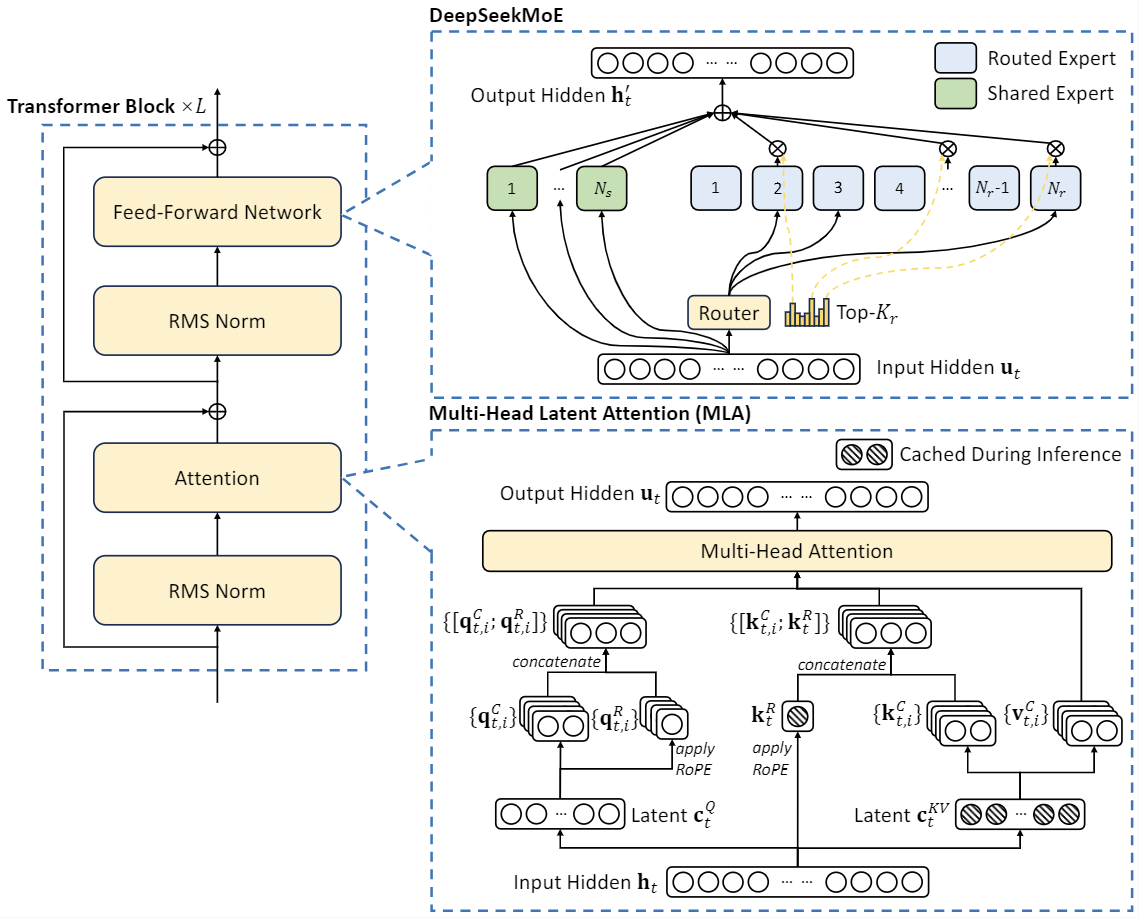

DeepSeek AI veröffentlichte am 6. Mai 2024 den Code und die Gewichte von DeepSeek-V2 unter einer offenen Lizenz. Das Mixture-of-Experts-Modell umfasst insgesamt 236 Milliarden Parameter, aktiviert pro Token aber nur 21 Milliarden.
DeepSeek nennt ein Kontextfenster von 128.000 Tokens. Gegenüber dem eigenen Vorgängermodell DeepSeek 67B sollen die Trainingskosten um 42,5 Prozent gesunken sein. Zugleich gibt das Team eine um 93,3 Prozent kleinere KV-Cache-Belegung und eine bis zu 5,76-fach höhere maximale Generierungsgeschwindigkeit an. Diese Werte stammen aus dem technischen Bericht des Projekts und sind Herstellerangaben.
Mixture of Experts für große Modelle
Bei der Mixture-of-Experts-Architektur werden nicht alle Modellparameter bei jedem Token aktiviert. DeepSeek beschreibt im technischen Bericht zu DeepSeek-V2, wie Multi-head Latent Attention und die MoE-Struktur den Speicherbedarf bei langen Kontexten begrenzen sollen. DeepSeek-V2 ist ein Sprachmodell. Die ursprüngliche Fassung des Beitrags behauptete zu Unrecht eine Verarbeitung von Bildern, PDFs und Scans, diese Angaben wurden entfernt.
Code, Gewichte und Einsatzumgebung
Der Quellcode liegt auf GitHub unter der MIT-Lizenz. Für die Modelle gilt eine separate Model License. Gewichte für DeepSeek-V2 und DeepSeek-V2-Chat stehen über Hugging Face bereit. Das Repository dokumentiert außerdem Wege für den Betrieb mit Transformers, vLLM und SGLang. Damit richtet sich die Veröffentlichung an Entwicklerteams, die ein großes Sprachmodell selbst betreiben oder in eigene Werkzeuge integrieren wollen.